ProactOS

Wir helfen den Menschen, die die Welt am Laufen halten, bessere Entscheidungen zu treffen.

Damit jede Reliability-Entscheidung zählt.

Top-Quartile-Reliability zu erreichen, war schon immer schwer. Heute sollen Anlagen länger, näher an ihren Grenzen und effizienter laufen — oft in Einrichtungen, die nie für die heutigen Betriebsanforderungen ausgelegt wurden, unter dem Druck, CAPEX und OPEX zu steuern, während erfahrene Fachleute immer schwerer zu finden sind.

ProactOS gibt Ihren Mitarbeitern die Intelligenz und den Kontext, um bessere Entscheidungen schneller zu treffen — und so mehr aus den Assets und Ressourcen zu holen, die Sie bereits haben.

Ihr CMMS steuert die Arbeit. ProactOS hilft Ihnen zu entscheiden, welche Arbeit zählt, warum sie zählt und was als Nächstes geschehen soll.

BEOBACHTEN → VERSTEHEN → ENTSCHEIDEN → HANDELN → LERNEN

  1. BEOBACHTEN

    Erfassen Sie, was im Feld und am Asset geschieht.

  2. VERSTEHEN

    Verbinden Sie Beobachtungen, Assetkontext, Ausfallarten, Historie, bestehende Maßnahmen und Reliability-Wissen.

  3. ENTSCHEIDEN

    Erkennen Sie, was am wichtigsten ist, und unterstützen Sie das Engineering-Team bei der richtigen Entscheidung.

  4. HANDELN

    Setzen Sie Entscheidungen in klare Maßnahmen um und verbinden Sie sie mit dem bestehenden Arbeitsprozess und Ihrem CMMS/EAM.

  5. LERNEN

    Halten Sie das Ergebnis fest und stärken Sie kontinuierlich die Reliability-Wissensbasis.

Illustratives Beispiel

Setzen Sie Expertise dort ein, wo sie am meisten zählt.

Industrielle Teams haben immer mehr Beobachtungen, Themen und mögliche Verbesserungen, als Zeit vorhanden ist. ProactOS hilft, diese Signale mit der Wirkung auf das Geschäft zu verbinden, damit Ihre Mitarbeiter die Arbeit priorisieren können, die am meisten zählt — während die übrige Arbeit sichtbar bleibt und gesteuert wird.

Ein Verdichter zeigt wiederkehrende ungewöhnliche Schwingungen.

Wo die Informationen bereits liegen

  • CMMS und EAM
  • Historian
  • Datenplattform
  • Engineering-Systeme
  • FMEA und Reliability-Wissen
  • Feldbeobachtungen
  • Dokumente und andere Quellen von Assetwissen

Das Problem ist kein Mangel an Daten. Die Informationen sind bereits da — sie sind oft nur nicht verbunden.

Die Realität

Das Reliability-Team hat bereits viele Dinge, die um Aufmerksamkeit konkurrieren: ein Verdichter mit wiederkehrenden Schwingungen, überfällige Instandhaltung, Beobachtungen der Operateure, Inspektionsbefunde, Chancen zur Reliability-Verbesserung, andere Equipment-Themen, geplante Instandhaltung und Verbesserungsprojekte. Nicht alles kann sofort untersucht werden.

Die Frage ist nicht: „Können wir Probleme finden?“ Die Frage ist: „Welche Probleme und Chancen verdienen zuerst unsere knappe Expertise und unsere Ressourcen?“

Ohne ProactOS

  • Die Informationen, die Sie zum Priorisieren brauchen, liegen oft verteilt im CMMS, EAM, Historian, in der Datenplattform, in Engineering-Systemen, FMEA, Beobachtungen, Dokumenten, Historie und Engineering-Wissen — nicht fehlend, nur nicht verbunden.
  • Teams wissen manchmal, dass etwas Aufmerksamkeit braucht, ohne sofort zu sehen, wie erheblich es ist, was geschehen kann, wenn es nicht angegangen wird, welche Geschäftsergebnisse betroffen sein könnten, ob bestehende Maßnahmen ausreichen oder wie es sich zu anderer konkurrierender Arbeit verhält.
  • Menschen können wertvolle Zeit in Themen stecken, weil sie sichtbar, dringend oder leicht zu bearbeiten sind — ohne zu wissen, ob das die Dinge mit dem höchsten Wert sind.

Mit ProactOS

  • ProactOS verbindet das betreffende Asset, die Ausfallarten, Beobachtungen, Historie, bestehende Maßnahmen und das Reliability-Wissen.
  • Es hilft dem Team, die mögliche betriebliche und geschäftliche Wirkung unterschiedlicher Themen und Chancen zu verstehen.
  • Höhere Priorität: Diese Themen haben die größte potenzielle Wirkung und verdienen zuerst Engineering-Aufmerksamkeit.
  • Niedrigere Priorität: Diese Themen bleiben relevant, können aber später überwacht, geplant oder angegangen werden.
  • Arbeit mit niedrigerer Priorität wird nicht ignoriert. Priorität wird sichtbar, damit Menschen bewusst entscheiden können, wofür sie ihre Zeit einsetzen.
  • Ingenieure und operative Führungskräfte entscheiden, was geschieht. ProactOS entscheidet nicht für sie.

ProactOS hilft Ihnen nicht einfach, mehr Arbeit zu finden. Es hilft Ihnen zu verstehen, welche Arbeit am meisten zählt.

Richten Sie Ihre Mitarbeiter auf die Entscheidungen und Maßnahmen, die für das Geschäft den größten Unterschied machen können.

Reliability wird schwieriger. Ihre Mitarbeiter brauchen bessere Unterstützung.

Industrielle Organisationen arbeiten in einer Welt mit engeren Grenzen.

Anlagen haben physische und konstruktive Grenzen. Betriebsfenster werden gedehnt. Investitionsentscheidungen stehen unter größerer Prüfung. Instandhaltungsbudgets stehen unter Druck. Und die erfahrenen Ingenieure und Techniker, die wissen, wie sich Assets wirklich verhalten, sind immer schwerer zu gewinnen, zu entwickeln und zu halten.

Sie können die Anlage nicht immer neu entwerfen.

Sie können nicht immer mehr Menschen hinzufügen.

Sie können das Instandhaltungsbudget nicht immer erhöhen.

Aber Sie können die Menschen, die Sie bereits haben, in die Lage versetzen, bessere Entscheidungen zu treffen.

ProactOS bringt den Reliability-Kontext, den Menschen brauchen, an einen Ort — Anlagenhierarchie, Ausfallarten, Instandhaltungsstrategie, Feldnachweise, Risiko und Maßnahmen.

Das Ergebnis ist eine Belegschaft, die sieht, was zählt, versteht, warum es zählt, und mit mehr Sicherheit und Wirksamkeit handelt.
Reliability engineer on the shop floor

Was bessere Reliability außerdem bedeutet

Zuverlässigere Assets und Anlagen laufen in der Regel mit weniger Verschwendung und niedrigeren Emissionen. Weniger ungeplante Ereignisse, ruhigerer Betrieb und weniger Energie und Material, die durch Ausfälle und Nacharbeit verloren gehen.

Das folgt aus besserer Reliability — nicht aus einem separaten Programm, und nicht etwas, das ProactOS allein für sich beanspruchen kann.

Eine Reliability-Intelligenzschicht über den Systemen und Daten, die Sie bereits haben

ProactOS verlangt nicht, dass Sie Ihr CMMS, EAM, Ihre Datenplattform oder Ihren Historian ablösen. Es kann neben der Technologie- und Datenlandschaft arbeiten, die Sie bereits haben — CMMS- und EAM-Plattformen, Datenplattformen und Data Lakes, Historians, Engineering-Systeme, Reliability-Datenbanken, operative Systeme, bestehende KI und Analytik sowie Dokumente und andere Quellen von Assetwissen, soweit verfügbar. Es nutzt und verbindet diese vorhandenen Informationen, statt Sie zu bitten, sie neu aufzubauen.

Ob Ihre Reliability-Informationen in einem CMMS, EAM, einer Datenplattform, einem Historian, einem Engineering-System, in Dokumenten oder in einer Kombination von Quellen liegen: ProactOS verbindet den relevanten Kontext, damit Ihre Mitarbeiter bessere Entscheidungen treffen können.

Ihre Systeme enthalten bereits wertvolle Informationen. ProactOS hilft, daraus den Kontext und die Intelligenz zu machen, die Ihre Mitarbeiter brauchen, um zu entscheiden, worauf sie sich konzentrieren.

ProactOS ersetzt Ihre Systeme nicht und schafft kein weiteres Datensilo.

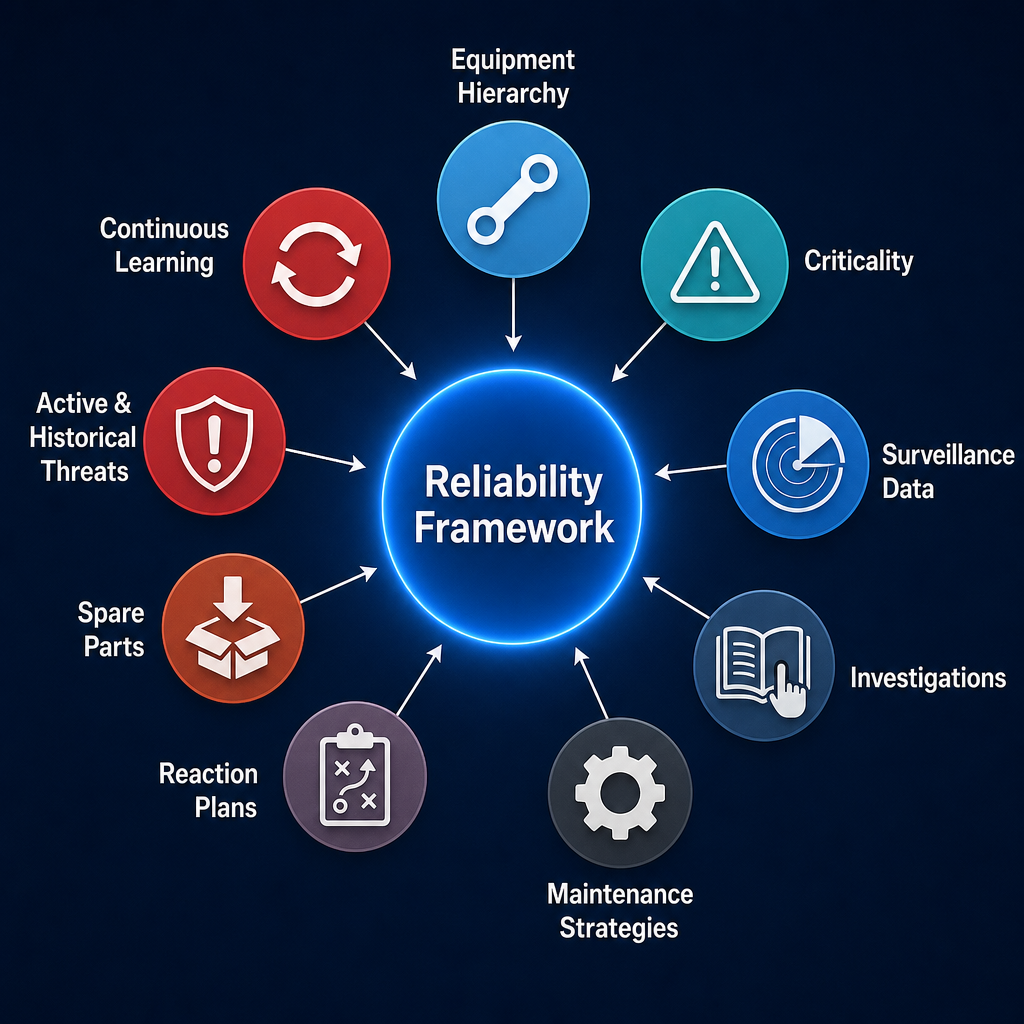
Reliability framework connecting hierarchy, criticality, surveillance, investigations, strategies, reaction plans, spares, threats, and learning
  1. Bestehende Technologie und Daten
  2. ProactOS
  3. Kontext, Intelligenz und Priorisierung
  4. Bessere Entscheidungen
  5. Bessere Maßnahmen
  6. Lernen

Anlagenhierarchie

Ein strukturiertes Bild der Assets, die Sie tatsächlich betreiben, ausgerichtet an ISO 14224, damit Reliability, Instandhaltung und Operations vom selben Assetkontext aus arbeiten.

Ausfallwissen und Strategie

FMEA, Ausfallarten und Instandhaltungsstrategien in einer kontinuierlich wachsenden Reliability-Wissensbasis, die von den Menschen gepflegt und verbessert werden kann, die die Anlage kennen.

Feldbeobachtungen und Risiko

Operateure und Techniker halten fest, was sie im Feld sehen. ProactOS verbindet Beobachtungen mit Assets, Ausfallarten und Risiko, damit Teams ihre Aufmerksamkeit dort bündeln, wo sie am meisten zählt.

Vom Erkenntnisgewinn zur Maßnahme

Setzen Sie erkanntes Risiko und Reliability-Entscheidungen in vereinbarte Maßnahmen und Instandhaltungsarbeit um — zum Beispiel neben den Arbeitsaufträgen, die Ihr CMMS bereits steuert.

Ursachenanalyse, wenn sie zählt

Nutzen Sie strukturierte Ursachenanalyse, wenn ein Ausfall, ein wiederkehrendes Problem oder eine operative Exposition eine tiefere Untersuchung rechtfertigt — ohne jedes Thema durch ein schweres Verfahren zu zwingen.

Ein gemeinsames Bild für die Schicht

Stellen Sie dieselben Risiken, Prioritäten, Maßnahmen und denselben Status den Menschen bereit, die handeln müssen — vom Reliability Engineer über den Supervisor bis zur Werkstatt.

Expertise verstärken. Nicht ersetzen.

KI kann helfen, Muster zu erkennen, Informationen zu verbinden und sichtbar zu machen, was Aufmerksamkeit verdient.

Aber industrielle Entscheidungen bleiben menschliche Entscheidungen.

ProactOS ist darauf ausgelegt, Engineering-Expertise zu verstärken — nicht, das Urteil der Ingenieure zu ersetzen.

Die Menschen, die für die Anlage verantwortlich sind, behalten die Kontrolle darüber, was geschieht.

Gebaut für die Menschen, die für Reliability verantwortlich sind

Wer

VP Reliability, Head of Asset Management, Maintenance Director, Plant Manager, Reliability Engineer — und ihre Teams und Organisationen, die Menschen, die die Assets in Betrieb halten.

Wo

Prozessanlagen, Waste-to-Energy, Chemie, Versorgung, Lebensmittel, Fertigung und andere assetintensive Industrien.

Beginnen Sie mit einer Unit

  • Einen strukturierten Asset- und Reliability-Kontext für eine ausgewählte Unit
  • Kritische Ausfallarten und Bedrohungen verbunden
  • Relevante Beobachtungen mit Assets und Ausfallarten verknüpft
  • Aktuelle Reliability-Exposure identifiziert
  • Vorrangige Reliability-Maßnahmen definiert
  • Nachweise zu Entscheidungen und Arbeit, die ProactOS beeinflusst hat
  • Eine klare Empfehlung: ausweiten, anpassen oder beenden

Beginnen Sie mit einer Unit. Belegen Sie den Wert. Entscheiden Sie danach.

So läuft ein 90-Tage-Pilot